独立博客或内容站上线后搜索引擎不收录,往往是因为技术细节导致。本文列举了五点原因及解决方案:Nginx防爬规则过于严格;URL规范性问题;动态Sitemap生成拖垮接口;多层重定向耗尽抓取配额;301重定向链过长。解决这些问题,可提升网站搜索引擎收录效果。
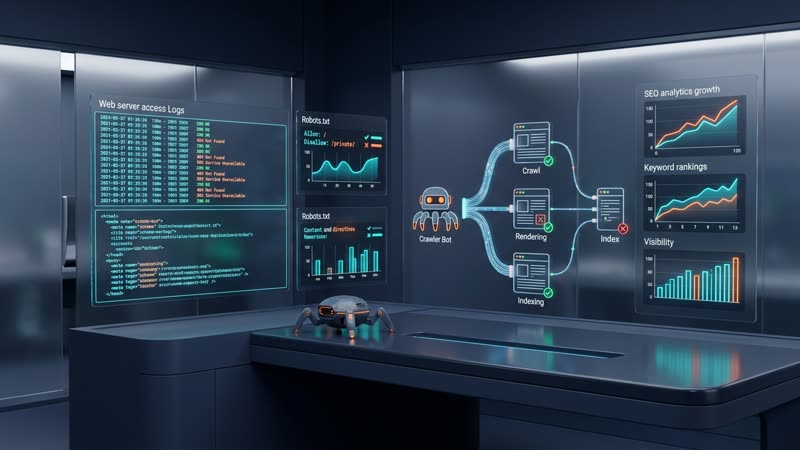
很多程序员自己搭好独立博客或者内容站,部署完就丢在那里等收录,结果过了一两个月去站长平台一看,索引量还是个刺眼的 0。我去年把几个站点的架构重构完时也碰到过这事。明明用浏览器访问飞快,页面排版也正常,各大搜索引擎的蜘蛛就是不落库。后来我蹲守服务器日志抓现场,才发现问题根本不是所谓新站玄学,而是好几个隐蔽的技术细节把爬虫卡死了。
Nginx 防爬规则写太死,顺手把正规蜘蛛当恶意脚本挡在门外
很多站长为了防扫描器或者恶意刷量,会在 Nginx 配置里加一些全局限速或者 User-Agent 过滤规则。我当时就图省事,直接从网上抄了一段屏蔽空 UA 和可疑爬虫的规则。
结果某天排查日志,发现百度爬虫(Baiduspider)和必应爬虫(bingbot)访问好几个聚合页直接返回了 403 和 429。
原因在于:很多现成的防爬规则是按照普通访客的频率设定的,比如单个 IP 限制每秒 2 个请求。但搜索引擎蜘蛛过来抓取时是突发并发,几秒钟内能发出几十个 GET 请求,直接就把 Nginx 的 limit_req_zone 顶爆了。更麻烦的是有些配置根据 UA 里的正则粗暴拦截,比如把包含特定关键字符的请求一刀切,误杀了合法蜘蛛。
排查办法是去服务器看 access.log,直接筛选爬虫的 UA,看看状态码到底是 200 还是 403 / 429 / 500:
grep -E "Baiduspider|Googlebot|bingbot" /var/log/nginx/access.log | awk '{print $9}' | sort | uniq -c如果日志里大批量的 403 和 429,爬虫来两次吃闭门羹,抓取配额就会直接断崖式下跌。解决办法是给官方白名单爬虫单独放行,在 limit_req 里用 $http_user_agent 配合 map 机制做白名单 bypass。
URL 斜杠与参数没归一化,同一个页面被当成多次重复
搜索引擎对 URL 的规范性要求极度苛刻。比如很多博客系统,下面这几个地址访问出来的其实是同一个内容:
https://www.example.com/post/123.htmlhttps://www.example.com/post/123.html?from=feedhttp://www.example.com/post/123.htmlhttps://example.com/post/123.html
还有目录类型的 URL,末尾带不带斜杠(/category/tech 对比 /category/tech/)。
如果服务端没有做强制的 Canonical URL 声明和 301 规范化跳转,搜索引擎会认为你这几个全是不一样的页面,但里面的正文完全雷同。轻则分散了单页的外链权重,重则触发算法的雷同内容降权。
我的做法有两个:
第一是在页面 <head> 里必须写死绝对路径的 Canonical 标签:
<link rel="canonical" href="https://www.example.com/post/123.html" />第二是在 Nginx 层面做全局 301 强制跳转,把不带 www 的域名直接跳到带 www,把纯 http 请求强制重定向到 https。千万别在页面加载完后再用前端 JS 去跳,爬虫往往根本不执行那段脚本。
动态 Sitemap 查询拖垮接口,蜘蛛抓取经常遇到 504 超时
很多 CMS 插件或者博客框架的 sitemap.xml 是每次请求实时查数据库生成的。文章少的时候没感觉,等到博客攒了上千篇文章、几万条标签关联时,搜索引擎蜘蛛一访问 /sitemap.xml,数据库就开始全表扫描。
那阵子我发现百度站长平台提示抓取异常,点进去看详细原因全是 504 Gateway Time-out。
因为爬虫抓取接口通常有严格的超时限制(一般是 3 到 5 秒),动态生成稍微卡一下,PHP 或者 Node 后端还在那里查 SQL,前端 Nginx 已经直接给爬虫掐断连接了。爬虫抓取超时次数一多,就会判定站点服务不稳定,降低后续的抓取频次。
解决办法别搞实时动态查询。用定时任务(比如 Linux crontab 每晚执行一次)把 sitemap.xml 预先生成静态文件写在磁盘上,Nginx 直接走静态文件分发:
location = /sitemap.xml {
    root /var/www/myblog/public;
    expires 1d;
    access_log off;
}
这样不管爬虫一天来抓几百次,全都是纳秒级的静态文件直出,根本占用不了后端资源。
多层重定向把爬虫绕晕,抓取配额在 301 链条里耗光
每个站点在搜索引擎眼里都有一个抓取配额(Crawl Budget)。配额主要根据服务器响应速度和整站质量来分配。
我之前改过一次全站伪静态规则,改完没做全量测试,结果整出了一个极其冗长的重定向链条:
爬虫从旧外链访问 http://example.com/archives/123;
第一跳:Nginx 发现不是 https,跳到 https://example.com/archives/123;
第二跳:域名没有 www,跳到 https://www.example.com/archives/123;
第三跳:博客路由规则判断是旧文章 ID,又跳到 https://www.example.com/post/my-article.html。
一个真实页面,爬虫要连续处理 3 次 HTTP 301 重定向才能拿到最终的 HTML。
很多爬虫对重定向跳转深度有限制,通常跳超过 2 次就直接放弃抓取了。就算勉强抓完,你的抓取配额全浪费在这些无意义的 301 握手上,正经的新文章根本轮不上被爬。
可以用 curl 跑一条命令自查重定向链条:
curl -ILs "http://example.com/archives/123" | grep -E "^HTTP|^Location"如果输出里出现了好几个 HTTP/1.1 301,必须把 Nginx 规则合并成一步到位。直接一步重定向到最终的带 www 和 https 的规范地址,绝不能环环相扣。
首屏没做资源压缩,TTFB 拖慢导致移动端抓取评分拉胯
现在的搜索引擎抓取主力基本都是移动端爬虫(比如 Googlebot Smartphone 和百度移动爬虫)。移动端算法对网页的首屏渲染速度和资源体积极度敏感。
有一次我发了一篇长文,里面顺手插了三张单反拍的高清图,每张都是三四兆的原始 PNG。在电脑上看因为网速快不觉得,到了移动端爬虫那儿,整个页面的 TTFB(首字节响应时间)和 LCP(最大内容渲染时间)直接飘红。
爬虫渲染引擎分配给单个页面的超时预算非常紧张。如果在规定时限内页面关键正文因为大图阻断没有渲染出来,爬虫抓到的快照就是残缺的,甚至直接放弃把这个页面列入索引。
解决办法非常直接:
所有上传的封面图和正文配图,必须在上传时跑一遍脚本压缩,分辨率控制在 1200px 以内,格式转为 WebP 或者经过高压的 JPG,单张体积坚决压在 200KB 以下。
Nginx 开启 gzip 或者 brotli 压缩,把 html、css、js 的传输体积压到原来的三分之一。
给图片标签加上 loading="lazy",别让非首屏的图片抢占关键网络连接。
日常怎么自查抓取状态
说了这么多配置,平时怎么知道蜘蛛到底来没来?别天天刷新站长后台,那上面的数据经常延迟两三天。直接去服务器终端看事实。
写个简单的统计命令,放进平时巡检的别名里:
awk -F'"' '/Baiduspider/{print $1, $2}' /var/log/nginx/access.log | tail -n 20看看爬虫最近几小时爬了哪些 URL,返回的 HTTP 状态码是不是清一色的 200。只要状态码正常、响应时间在两三百毫秒以内,剩下要做的就是按部就班更新有实际内容的技术文章,索引量自然会稳步上来。
文章标题:网站上线后死活不收录?我给博客排查 SEO 抓取异常踩过的 5 个硬核坑
文章链接:https://www.llbbs.cn/jishujaocheng/277.html
本站文章均为原创,未经授权请勿用于任何商业用途
评论一下?