网站采用多条件属性筛选后,搜索收录和核心词排名暴跌,原因在于参数排列组合导致蜘蛛黑洞和Canonical失效。作者分析了爬虫对URL参数的抓取机制,指出参数组合过多导致内容稀释和爬虫资源浪费,并提出了应对策略。
做内容站点或者资源库,只要数据量破了万级,默认的扁平分页就很难满足读者的找内容诉求。去年年中我给手头的一个内容聚合站做重构,前端和后端一合计,决定上一套体验极佳的“多条件属性分面筛选(Faceted Navigation)”:读者不仅可以挑主分类,还能在侧边栏并行勾选多标签、发布年份、文档格式、阅读难度,甚至还能指定按浏览量、评论数或更新时间排序。
本地和预发环境测试时,这套交互顺滑得无可挑剔。点击筛选项,前端用无刷新渲染局部更新列表,URL 栏同步用 history.pushState 拼出对应的 Query 参数,不管怎么筛选都能一键复制链接分享给其他人。当时我还觉得给站点补齐了一块核心体验拼图。
上线仅仅过去三周,监控系统里的警报声就没停过。诡异的是,报警不是因为前端报错,而是站点的搜索收录和核心流量彻底崩了。在百度搜索资源平台和 Google Search Console 里,全站核心关键词排名几乎腰斩,收录量曲线更是一场过山车——两周内从原先平稳的 6 万条陡增到了 38 万条,随后直接跳水跌破 1.5 万条。更致命的是,平时当天发的新文章,蜘蛛以前两小时内必来抓取,那阵子隔了四五天快照依然毫无动静。
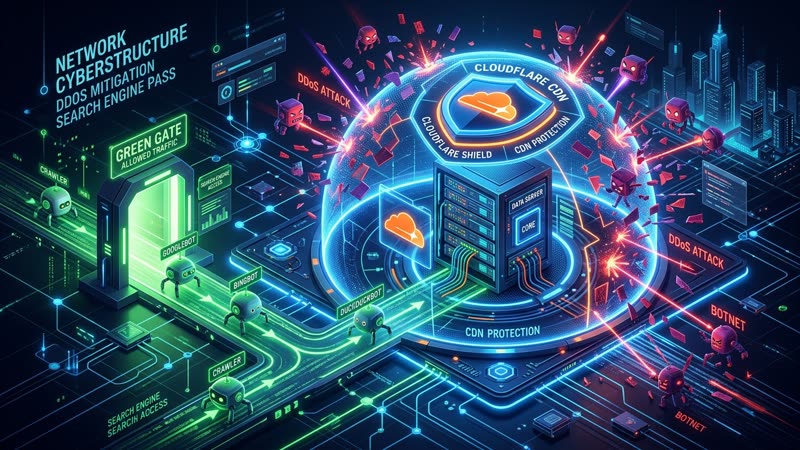
登录服务器扒开 Nginx 的 access.log,那一幕直接让我后背发凉:几个主流搜索引擎的爬虫 IP 像疯了一样,每秒几十个并发在疯狂刷各种参数拼接的 URL。爬虫的并发请求几乎把后端的数据库慢查询日志塞满,全站原有的正常内链抓取配额被这套筛选参数彻底吞噬。
这篇记录把这次分面筛选改造引发的技术 SEO 灾难拆解出来,把背后的机制和最终落地的治理方案说清楚。
蜘蛛黑洞:参数排列组合引发的“维度爆炸”
很多做开发的朋友在设计 URL 参数时,往往从功能实现出发,觉得 ?cat=3&tag=15&year=2024&sort=views 不过是几个简单的 SQL 查询条件。但在搜索引擎爬虫眼里,每一个不同的 Query String 都是一个全新的待抓取网页。
假设站内设计了 5 个维度的筛选项:
- 主分类(10 个选项)
- 标签(30 个选项)
- 年份(5 个选项)
- 文档格式(4 个选项)
- 排序规则(4 个选项)
只要前端在渲染页面时把每一个筛选条件都写成标准的 HTML 超链接(<a href="...">),爬虫就会不知疲倦地顺着链接一层层往下爬。在不考虑空值的情况下,理论上的组合数就达到了:
$$10 \times 30 \times 5 \times 4 \times 4 = 24,000$$
但这还只是第一层灾难。
更要命的是参数顺序。如果用户先点标签后点分类,URL 可能是 ?tag=15&cat=3;反过来点,URL 就变成了 ?cat=3&tag=15。对数据库查询来说,WHERE cat=3 AND tag=15 和 WHERE tag=15 AND cat=3 毫无区别,但在 HTTP 规范和搜索引擎爬虫的 URL 唯一哈希表里,这两个是完全独立的资源标识符。
再加上每个筛选结果底下还有分页参数(&page=1、&page=2...),组合数瞬间暴增到几十万甚至上百万量级。
爬虫对一个站点的抓取预算(Crawl Budget)是有严格上限的。服务器响应越慢,配额衰减越快。爬虫天天在这些庞大的排列组合迷宫里打转,把宝贵的配额全耗在无意义的死胡同里,网站真正有价值的核心文章自然连露脸的机会都没了。
更可怕的是内容稀释(Thin Content)。很多冷门的交叉组合(比如“2021年 + PDF格式 + 入门级 + 某个偏门标签”)根本筛选不出内容,页面只显示一个“暂无相关数据”或者只有一条孤零零的记录。搜索引擎抓取了成千上万个这类几乎空荡荡的页面,算法很快就会给整站打上“批量生成低质垃圾页”的惩罚标签,全站降权也就顺理成章了。
当时我情急之下想到的第一个应对策略,就是直接在 robots.txt 里加一条规则:
User-agent: *
Disallow: /*?*
这差点成了压垮骆驼的最后一根稻草。
很多人以为 Disallow 能阻止搜索引擎收录垃圾页,其实大错特错。Disallow 只是告诉爬虫“不要去抓取这个 URL 的正文内容”,并不能阻止该 URL 本身进入搜索索引库!只要站内或站外有链接指向这些带问号的地址,搜索引擎依然会把这些 URL 建库索引,只不过搜索结果里展示为“由于该网站的 robots.txt,没有此页面的描述信息”。
不仅如此,整站带问号的合法分页、带合理参数的专题聚合页也被这行规则一刀切干掉了,直接引发了更严重的次生灾害。
Canonical 并不是银弹:跨筛选页语义背离与作弊判定
在发现 robots.txt 帮倒忙之后,我转向了技术 SEO 里最常被提及的方案:Canonical 规范标签。
当时的思路很直白:既然所有的筛选结果都是从基础分类页派生出来的,那我在所有带筛选参数的页面 <head> 里,统一放一个指向无参数分类根路径的 Canonical 标签不就完事了吗?
<!-- 在 https://example.com/category/backend?tag=redis&year=2024 页面中 -->
<link rel="canonical" href="https://example.com/category/backend" />
我满心以为爬虫看到这个标签后,会自觉把所有筛选页面的权重归并到 /category/backend 上,同时不再重复建立索引。
现实又狠狠上了一课。上线一周后拉取 Google Search Console 的“网页未编入索引原因”,赫然出现大批警告:“Google 选定的规范网页与用户指定的不同(Google chose different canonical than user)”。
在搜索引擎的白皮书和底层算法实现中,rel="canonical" 始终是一个强建议,而不是强制命令。爬虫在处理 Canonical 时,第一步是对比当前页面与目标 Canonical 页面的内容重合度与语义相似度。
如果当前页面勾选了三个过滤条件,列表里展示的是 5 篇专门讲 Redis 集群运维的高级文章;而目标 Canonical 页面 /category/backend 是一个综合性的后端分类首页,展示的是最新的 20 篇涵盖 Java、Python、MySQL 的杂项文章。两者的正文文字、标题、H 标签、内链重合度甚至不足 15%。
这种情况下,搜索引擎的内容指纹对比算法会判定:站长标注的 Canonical 与页面实际表达的内容严重背离。一旦算法判定 Canonical “不可信”,它不仅会直接忽略这个标签,继续把当前参数页作为独立内容编入索引,甚至会降低整个域名下其他合法 Canonical 标签的信任评分。
把内容差异巨大的过滤页强行用 Canonical 指向首页或顶层列表页,在现代搜索引擎的算法视野里,往往会被判定为试图操纵排名的作弊手段。
边缘规整:Nginx 参数排序去重与 301 归一化
既然参数顺序混乱和无效参数是炸出冗余 URL 的罪魁祸首,那就必须在流量触达后端应用前,在 Nginx 网关层完成清洗和规范化。
许多框架在拼接 URL 时毫无章法,?tag=go&cat=2 和 ?cat=2&tag=go 同时存在;还有一些统计系统或广告爬虫会在链接后拼接 from=timeline、spm=xxx 等无意义的跟踪参数,甚至带上 &tag=&sort= 这种空值参数。
为了从网络边缘阻断这些重复变种,我在 Nginx 配置中引入了参数归一化逻辑。如果你的 Nginx 编译了 Lua 模块(如 OpenResty 或自带 lua-nginx-module),可以用几行轻量脚本在内存中完成参数字典排序和垃圾参数剔除。
下面是经过线上验证的核心逻辑:
-- /etc/nginx/lua/normalize_query.lua
local args = ngx.req.get_uri_args()
if not args or type(args) ~= "table" then
    return
end

-- 过滤白名单以外的杂乱参数与空参数
local clean_args = {}
local allowed_keys = { cat = true, tag = true, year = true, sort = true, page = true }

for k, v in pairs(args) do
    if allowed_keys[k] and v ~= "" and v ~= true then
        clean_args[k] = v
    end
end

-- 按照键名进行字典排序并重新拼接
local keys = {}
for k in pairs(clean_args) do
    table.insert(keys, k)
end
table.sort(keys)

local sorted_pairs = {}
for _, k in ipairs(keys) do
    local val = clean_args[k]
    if type(val) == "table" then
        table.sort(val)
        for _, sub_val in ipairs(val) do
            table.insert(sorted_pairs, ngx.escape_uri(k) .. "=" .. ngx.escape_uri(sub_val))
        end
    else
        table.insert(sorted_pairs, ngx.escape_uri(k) .. "=" .. ngx.escape_uri(val))
    end
end

local new_query = table.concat(sorted_pairs, "&")
local raw_query = ngx.var.args or ""

-- 如果原始请求的参数顺序不对,或者夹带了被清洗掉的垃圾参数,执行 301 规范化跳转
if raw_query ~= new_query then
    local target = ngx.var.uri
    if new_query ~= "" then
        target = target .. "?" .. new_query
    end
    return ngx.redirect(target, ngx.HTTP_MOVED_PERMANENTLY)
end
在 Nginx 主配置的 server 块中载入该逻辑:
server {
    listen 443 ssl http2;
    server_name www.example.com;

    location /articles/ {
        # 只对带参数的 GET 请求执行查询参数重整
        if ($is_args) {
            rewrite_by_lua_file /etc/nginx/lua/normalize_query.lua;
        }

        proxy_pass http://backend_upstream;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    }
}
没有安装 Lua 模块的精简环境,也可以使用 Nginx 原生的 map 指令配合正则,把常见的无意义追踪参数剥离,并对多余的尾部问号做 301 规整:
# 剔除常见的营销统计与空查询参数
map $args $clean_query_string {
    ~(.*)(?:&|^)(?:utm_[^&]+|from=[^&]+|spm=[^&]+)(.*) $1$2;
    default $args;
}

server {
    listen 443 ssl http2;
    server_name www.example.com;

    # 去除首尾由于正则替换可能遗留的多余 & 符号
    if ($args ~* "(?:^&|&$|&&)") {
        set $clean_args $args;
        # 简单重定向到规整地址
    }
}
经过网关层的排序与过滤,原本散落在外网的 10 种参数顺序排列组合被全部强行收敛到唯一的标准形式,后端缓存命中率直接提升了数倍,更斩断了爬虫在等价不同 URL 之间无限打转的链路。
根治方案:分面导航的收录分级与 noindex, follow 实践
网关层参数归一化解决了“无序”的问题,但无法解决“维度本身过多”的问题。哪怕参数再整齐,20 个标签乘以 5 个年份,依然有上百个组合。
真正的工程化解法,必须从信息架构的分级治理入手:搞清楚哪些页面配被搜索引擎收录,哪些页面坚决只属于端内交互。
1. 建立严格的“收录白名单”
不是所有筛选条件都具备 SEO 价值。我把站内所有维度的组合分成了两类:
-
具备独立搜索意图的高价值单一维度:例如单独筛选“技术分类”或者单独筛选“高频核心标签”。网民在搜索引擎里确实会搜“Python 教程”、“Docker 踩坑”。这类页面不仅要允许收录,而且要剥离 Query 参数,直接重构成层级清晰的伪静态目录:
/category/backend//tag/docker/
这类页面配置规范的自引用 Canonical、定制的 Title 和 Meta 描述,并生成到站点地图 Sitemap 中。
-
纯属即时检索的多条件混合筛选:例如“分类=后端 & 标签=docker & 排序=最多评论”。根本不会有人去搜这么长尾的组合。这类页面本质上是用户的一次即时交互视图,必须彻底阻断搜索引擎的建库。
2. 前端超链接切断:不要把每个复选框都做成 <a href>
传统模板渲染分面筛选列表时,最致命的习惯就是把侧边栏每一个选项都套上标准的 HTML 超链接标签:
<!-- 致命写法:把多条件排列组合直接喂到爬虫嘴里 -->
<a href="/articles?cat=devops&tag=k8s&status=open">Kubernetes (12)</a>
这种写法等于在每个页面上向蜘蛛伸出几十根探针。
改进方案非常清晰:
- 对人类用户,改用
<button>或带有data-*属性的非链接标签,通过前端 JavaScript 监听点击事件并触发数据拉取,通过history.replaceState改变浏览器地址栏:<span class="facet-option" data-facet="tag" data-value="k8s" role="button"> Kubernetes (12) </span> - 对爬虫,由于爬虫默认不会去模拟点击没有
href属性的普通标签,它自然不会顺着多选组合漫无目的地向下抓取。在需要兼顾无 JS 兜底的可访问性场景下,可以用<form method="POST">提交筛选,爬虫天然遵守不会主动爬取 POST 表单的行业规范。
3. 多条件页面的兜底守卫:noindex, follow
即使前端移除了链接,外链、用户分享、老旧快照依然可能把爬虫带到带参数的多条件页面上。
这时候就轮到了最关键的兜底防护:在所有命中多条件组合筛选的页面上,动态输出 noindex, follow。
很多技术人员容易把 noindex 和 nofollow 混为一谈,或者直接写上 noindex, nofollow。这里必须强调两者的区别:
noindex:明确告诉搜索引擎“这个页面不要放进搜索索引库”。follow:明确告诉搜索引擎“页面本身不要索引,但页面里列出的那些具体文章链接,请你继续顺着爬下去”。
这正是我们梦寐以求的效果!多条件筛选页本身是个垃圾聚合壳,不需要它排词;但筛选出来的每一篇具体文章是货真价实的干货,我们需要爬虫顺着内容流抓到它们。
在后端模板代码中加入判断逻辑:
# 伪代码:判断当前筛选参数是否超过一个维度
query_params = request.GET
valid_facet_keys = {'cat', 'tag', 'year', 'format', 'sort'}
active_facets = [k for k in query_params.keys() if k in valid_facet_keys and query_params.get(k)]

# 如果同时选中了 2 个或以上的过滤维度,或者包含了排序参数
is_multi_facet = len(active_facets) >= 2 or 'sort' in active_facets

if is_multi_facet:
    # 动态插入 noindex, follow 指令
    response_headers['X-Robots-Tag'] = 'noindex, follow'
    robots_meta = '<meta name="robots" content="noindex, follow">'
else:
    robots_meta = '<meta name="robots" content="index, follow">'
推荐直接在 HTTP 响应头里注入 X-Robots-Tag: noindex, follow。有些爬虫在解析大体积 HTML 时可能会因为超时只读取前几千字节,如果 <meta> 标签放得太靠后可能会被漏掉,而 HTTP Header 则是握手阶段就能百分之百触达爬虫的第一道防线。
4. 配合站长平台的参数规整指令
在网站自身架构梳理清楚后,最后一步是主动向各大站长后台报备参数语义。
在 Google Search Console(以及以往支持 URL 参数工具的国内站长平台)中,可以明确告知引擎:
sort参数:指定其用途为“改变排序方式”,指引爬虫只爬默认排序页面。track_id、from参数:指定其用途为“跟踪统计”,指引爬虫抓取时主动剥离该参数。page参数:指定其用途为“分页控制”。
这样可以在爬虫调度队列层面就截断冗余任务的发起,彻底卸下源站服务器的无效计算开销。
效果检验与几个复盘细节
整套治理措施全部上线后,收效不是立竿见影的,搜索引擎消化历史索引通常需要几周甚至几个月的时间。
第一周,最直观的反馈来自服务器监控。Nginx 针对爬虫 IP 的 QPS 峰值直接暴跌了 75%,原本居高不下的 CPU 占用率从 80% 掉回了 20% 以下,后端缓存命中率稳固在 90% 以上。
第四周,各大站长平台的索引曲线开始呈现戏剧性变化:此前暴增的 38 万条收录量开始断崖式回落,每天都有数千个带有废弃筛选参数的死链被批量剔除出库。
第二个月末,全站的有效索引量重新回缩到干净的 5.5 万条左右,但与此对应的核心词曝光量和自然点击率不仅收复了失地,反而比重构前上涨了近 30%。更让人踏实的是,新发布的文章重新恢复了“当天发布、当天抓取收录”的高权重待遇。
在做复杂站点架构时,产品和交互往往只看前台用户点得爽不爽,而技术运维和架构师必须时刻盯着背后的协议层和爬虫生态。多条件筛选是一把锋利的双刃剑,放任自流就会演变成摧毁站点的蜘蛛黑洞;只有用严格的规范化网关、精准的收录分级和正确的元数据标记把它约束在轨道之内,才能在守住 SEO 基本盘的同时,把良好的检索体验完整交到读者手里。
文章标题:为了提升查找体验给网站加了多条件属性筛选(Faceted Search),全站收录与核心词排名却断崖式暴跌?排查参数排列组合炸出海量蜘蛛黑洞、Canonical 跨筛选页被判作弊失效、Nginx 参数规整排序与 noindex, follow 精细化分级我踩过的几个深坑
文章链接:https://www.llbbs.cn/jishujaocheng/287.html
本站文章均为原创,未经授权请勿用于任何商业用途
评论一下?