为提升页面秒开体验,采用Chrome推测规则API与链接预取,却导致搜索引擎收录与排名大幅下滑。问题源于预取并发过多、Vary头缺失、规则通配符误抓等,需优化配置以避免对搜索引擎造成负面影响。
上季度为了死磕 Core Web Vitals 里的 LCP 和跳转延迟,我们前端组把目光投向了 Chrome 官方力推的推测规则(Speculation Rules API)。
当时评估的初衷很美好:传统的 <link rel="prefetch"> 只能粗糙地预取静态文件,不支持执行,而且跨页面上下文调度非常笨拙。而 Speculation Rules API 直接由浏览器底层引擎驱动,支持在后台预渲染完整 DOM(prerender),甚至能根据用户的悬停(hover)毫秒数或视口曝光自动触发。在本地和预发环境测试时,页面点击几乎是真正的“零延迟秒开”,从列表页点进详情页就像在翻本地原生应用,内部体验评审时全员给出了极高评价。
灰度上线全站后的前两周,前端监控上报的导航耗时(Navigation Timing)直线下跌,首屏体验曲线漂亮得不行。
然而到了第三周,例行监控看板直接亮起了一片刺眼的红色。
百度站长后台的索引量曲线呈现出断崖式下挫,抓取异常率暴增了近 4 倍;Google Search Console 里也涌出大批“已抓取 - 尚未编入索引”与“服务器错误 (5xx)”。核心品类词的搜索快照要么变成了一片残缺的空壳,要么更新时间彻底停滞在半个月前。与此同时,运维群里的报警开始接二连三地炸锅:Nginx 网关在凌晨和午间爬虫抓取高峰期频繁出现 504 Gateway Timeout,源站后端实例的 CPU 和数据库连接池好几次差点被活活抽干。
原本只是为了改善真实用户的跳转体验,为什么这套技术会在技术 SEO 的底层生态里撕开这么大一个口子?
带着全组把近半个月的 Nginx 访问日志、CDN 边缘日志以及爬虫抓取轨迹逐条拉出来交叉比对,才发现推测规则和搜索引擎蜘蛛之间存在好几处隐蔽至极的架构冲突。
坑一:推测规则视口监听炸出海量并发,打爆源站网关致爬虫频吞 504
上线推测规则时,很多前端同学为了图省事,直接在全局布局模板里塞了一段“全局视口抓取”规则:
<script type="speculationrules">
{
  "prefetch": [
    {
      "source": "document",
      "where": {
        "and": [
          { "href_matches": "/*" },
          { "not": { "href_matches": "/admin/*" } },
          { "not": { "href_matches": "/api/*" } }
        ]
      },
      "eagerness": "viewport"
    }
  ]
}
</script>
配置里的 "eagerness": "viewport",意味着只要页面中的链接出现在可视区域,浏览器就会自动对目标 URL 发起预取请求。
人类用户浏览网页时,屏幕尺寸有限,往下滚动也是循序渐进的,一次可能也就预取三五个链接。但在搜索引擎爬虫眼里,情况完全不同。
像 Googlebot、Bingbot 这类具备 JavaScript 渲染能力(WRS)的现代爬虫,在运行无头渲染沙箱(Headless Chromium)时,为了完整提取页面内的布局、懒加载内容和内链结构,通常会把渲染视口的高度拉得非常大(有时候直接模拟 1080x3000 甚至更长的高分辨率长屏)。
这一拉,直接把列表页、归档页上的 40 到 60 个内链一次性全部扔进了“视口可见”范围。
无头沙箱里的推测执行引擎瞬间被激活,在主页面 HTML 还没完全解析完毕的短短几百毫秒内,并行向后端服务器轰出四五十条 HTTP 预取请求。而搜索引擎为了快速遍历全站,本身就会启动多组抓取 Worker 顺着内链同时并发爬取。
双重并发叠加之后,原先单次爬虫访问产生 1 次请求的场景,骤增成了 1 次访问衍生出 50+ 次后台预取风暴。
查看那几天的 Nginx 错误日志,真相一清二楚:
2026/10/18 04:12:35 [error] 4812#4812: *910243 upstream timed out (110: Connection timed out) while reading response header from upstream, client: 66.249.66.X, server: www.llbbs.cn, request: "GET /article/node-memory-leak.html HTTP/1.1", upstream: "http://127.0.0.1:3000/article/node-memory-leak.html", host: "www.llbbs.cn"网关连接池瞬间被预取请求挤占一空,Node.js 服务端渲染(SSR)实例的事件循环严重拥堵。当真正的搜索引擎主抓取进程过来请求正文页面时,直接被堵在网关外面,最终拿到的是冷冰冰的 504 Gateway Timeout 或 429 Too Many Requests。
爬虫反复遭遇超时,系统机制判定该站点“承载能力不足”,直接调低了全站抓取配额(Crawl Budget),新文章自然迟迟得不到收录。
排坑与修复:
-
彻底废弃列表页面的
eagerness: viewport,降级为悬停激进(moderate)或点击激进(conservative):
对于翻页列表、归档聚合等链接密集的页面,绝不能给通配符规则套上viewport。将其改为moderate(用户鼠标指针悬停超过 200ms)或者conservative(用户按下鼠标左键或开始点击),直接掐断无头爬虫在加载期自动并发预取的根源:{ "prefetch": [ { "source": "document", "where": { "href_matches": "/article/*" }, "eagerness": "moderate" } ] } -
在 Nginx 层面识别推测请求头,做独立限流隔离:
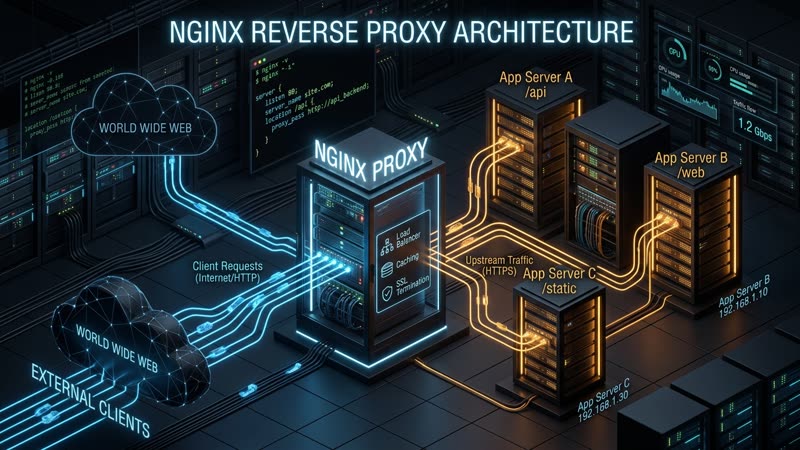
浏览器发送推测请求时,规范强制要求携带Sec-Purpose: prefetch或Purpose: prefetch请求头。我们在 Nginx 层将这部分流量与正常主请求分离,建立独立的缓冲队列,宁可丢弃多余的预取,也绝不让它影响主页面的响应:# 识别推测预取请求 map $http_sec_purpose $is_speculation_request { default 0; "prefetch" 1; "prerender" 1; } # 对推测流量应用更严格的限流区 limit_req_zone $binary_remote_addr zone=speculation_limit:10m rate=10r/s; server { location / { if ($is_speculation_request) { limit_req zone=speculation_limit burst=5 nodelay; } proxy_pass http://node_backend; } }
坑二:CDN 缓存缺失 Vary: Sec-Purpose,残缺预取快照投毒正常抓取
为了在推测预取时节约移动端用户的流量和服务器算力,后端团队特意在 SSR 框架里做了一层“减负逻辑”:
如果检测到请求头包含 Sec-Purpose: prefetch,由于此时浏览器只是想预热 HTML 文本和骨架,服务端就会跳过下方沉重的“相关推荐计算”、“评论列表拉取”以及“第三方营销代码打点”,直接吐出一个精简版的轻量 HTML。
想法本身合情合理,但大家唯独漏掉了全站最关键的一环:反向代理与 CDN 边缘缓存层。
默认情况下,Nginx 和绝大部分 CDN 厂商(无论是 Cloudflare 还是国内的云厂商 CDN)在缓存一个页面时,缓存键(Cache Key)默认仅由以下几部分构成:
$scheme$request_method$host$request_uri这意味着 CDN 根本不会去看请求头里有没有 Sec-Purpose。
事故的连锁反应随即展开:
- 一名使用 Chrome 的真实访客打开首页,鼠标在某篇技术文章链接上掠过;
- 浏览器后台自动发出带
Sec-Purpose: prefetch的预取请求; - CDN 节点未命中缓存,回源拉取,服务端如约返回了精简版的轻量 HTML;
- CDN 节点把这份精简版 HTML 当作普通网页缓存了下来;
- 几秒钟后,百度蜘蛛(Baiduspider)顺着收录链接爬取这篇文章(蜘蛛请求是不带
Sec-Purpose的); - CDN 节点直接从内存里掏出刚刚缓存的精简版 HTML,当场吐给百度蜘蛛!
百度蜘蛛抓回来的页面快照,相关阅读全空,评论区全空,文末结构化标签残缺不全,字数整整缩水了三分之二。百度判定该页面内容稀疏(Thin Content),直接调低该页面的评分。
反过来,更恶劣的情况是预取返回的 304 或者带特殊降级头的内容被缓存,导致普通用户后续访问也经常出现样式丢失或白屏。
排坑与修复:
-
响应头必须补齐
Vary: Sec-Purpose, Purpose:
只要服务端依据推测请求头输出了不同内容,就必须在 HTTP 响应头中明确告知所有下游缓存中间件:# 服务端响应头增加 Vary 声明 add_header Vary "Sec-Purpose, Purpose, Accept-Encoding" always; -
在 CDN 和 Nginx 缓存键中纳入推测状态:
如果确实要在边缘节点缓存推测响应,必须将推测头显式追加进 Cache Key 中,实现内容物理隔离:# 区分普通页面缓存与推测预取缓存 proxy_cache_key "$scheme$request_method$host$request_uri$http_sec_purpose"; -
对于高风险页面直接针对推测请求禁用公共缓存:
在处理带鉴权状态或动态结构化标记的内容时,最稳妥的策略是直接在预取响应中下发Cache-Control: private, no-store,禁止 CDN 和浏览器共享缓存池。
坑三:规则通配符被国内爬虫正则提取,炸出海量无效 404
这是排查过程中最让人哭笑不得的一个技术暗坑。
在定义 Speculation Rules 时,官方支持通过 JSON 配置 URL 模式匹配,例如:
<script type="speculationrules">
{
  "prefetch": [
    {
      "source": "document",
      "where": {
        "and": [
          {"href_matches": "/category/*"},
          {"href_matches": "/tag/*"},
          {"href_matches": "/archives/*"}
        ]
      }
    }
  ]
}
</script>
在遵守 W3C 规范的现代浏览器中,这段 JSON 只是一串规则配置,浏览器会提取当前 DOM 里的真实 <a> 标签,用配置里的正则去过滤匹配项。
但国内搜索引擎的爬虫抓取管道,并不是每个页面都会完整过一遍无头渲染沙箱。为了控制算力成本,百度、360、搜狗等搜索引擎有很大一部分基础蜘蛛,依然在跑基于正则表达式的粗暴文本解析器。
这类抓取分析器会把 HTML 文档里的所有字符串过一遍 URL 正则。当分析器扫描到 <script type="speculationrules"> 标签内部时,它根本不知道这是结构化推测规则,而是直接把双引号包裹的 /category/*、/tag/*、/archives/* 当成了页面上存在的普通相对超链接!
于是,我们在日志里抓到了海量由国内蜘蛛发出的畸形请求:
123.125.114.X - - [19/Oct/2026:09:44:12 +0800] "GET /category/* HTTP/1.1" 404 162 "-" "Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)"
123.125.114.X - - [19/Oct/2026:09:44:15 +0800] "GET /tag/* HTTP/1.1" 404 162 "-" "Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)"
星号 * 根本不是合法的后端路由参数,Nginx 和后端路由自然毫不犹豫地返回 404 Not Found。
全站几十万个页面,每个页面都挂着这几条通配符规则。几天之内,百度站长后台的“死链与 404 监控”里瞬间堆积了上万条形如 /category/* 的报错链接。
搜索引擎算法会监控整站的 404 比例。当一个网站在短时间内爆发式涌现成千上万个死链时,整站的健康度评分会被大幅扣减,抓取系统会认为该站点存在大量损坏结构,直接缩减每日抓取配额。
排坑与修复:
-
废弃通配符正则,改用显式 URL 列表(
source: "list")或限制性选择器:
在静态模板中,尽量避免使用裸露的带通配符路径。如果是确定要预取的关键链接,直接传具体 URL:<script type="speculationrules"> { "prefetch": [ { "source": "list", "urls": ["/category/frontend.html", "/category/devops.html"] } ] } </script> -
在 Nginx 层面做通配符拦截兜底,直接返回 410 或重定向:
防止历史快照里的星号请求继续污染死链监控,在 Nginx 顶部配置拦截并直接封堵,避免打到后端:# 拦截爬虫正则误抓的通配符路径 location ~* ^/(category|tag|archives)/\*\$ { access_log off; return 404; # 或者用 410 Gone 告知爬虫该资源已彻底注销 }
坑四:预渲染(Prerender)执行带副作用的 GET 请求,踩爆幽灵数据与计数器
如果说 prefetch 只是预先拉取 HTML 文件,那么推测规则里的 prerender 就是把核弹装进了页面。
prerender 会在浏览器不可见的后台隐藏标签页(Prerendering Context)中,完整解析 HTML、执行 JavaScript 脚本,甚至构建完整的渲染树。
前端最初为了把“热门文章”的打开体验做到极致,对首页的前三篇推荐文章启用了 prerender:
{
  "prerender": [
    {
      "source": "list",
      "urls": ["/article/top-pick.html"],
      "eagerness": "moderate"
    }
  ]
}
紧接着,数据后台和监控指标全部乱了套。
我们的文章阅读数统计原本是在客户端组件挂载时,通过一条 GET 请求向服务端打点:
// 客户端统计逻辑(原方案)
useEffect(() => {
  fetch(`/api/article/view-count?id=${articleId}`);
}, [articleId]);
当首页被访问,用户的鼠标哪怕只是不小心晃过了顶部的推荐卡片,浏览器就在后台完整执行了推荐页面的代码。用户最终根本没有点击进入那篇文章,但后端计数接口已经结结实实执行了一遍。
仅仅过了一个周末,首页几篇热门文章的阅读量就虚增了十几倍。更严重的是,部分文章页面内挂有按需生成防盗链接、临时 Token 的初始化请求,这些本该由用户真正入场时才消耗的凭证,全部在后台被预渲染提前透支消耗,导致用户真正点进去时反而提示“Token 已过期”或“访问鉴权失效”,弹窗报错。
不仅普通用户受害,当带有执行能力的爬虫在渲染沙箱里漫游时,这些具有状态变更性质的后台逻辑被成批触发,产生了一大堆没有来源关联的幽灵数据,把数据库的慢查询日志刷得满满当当。
排坑与修复:
-
严格遵循 HTTP 语义,严禁在 GET 请求中夹带任何具有副作用的状态变更:
浏览统计、Token 交换、会话初始化等操作,必须强制改为 POST 接口或专门的 Beacon 上报。推测引擎对具有潜在修改行为的操作有着天然的隔离防线,但前提是开发者不能把写操作伪装在 GET 之下。 -
前端代码显式检测
document.prerendering状态:
如果页面确实有一些初始化行为必须在正文加载时执行,务必加入浏览器状态检测。当页面处于预渲染状态时挂起执行,直到用户真正激活页面时再触发:function runAfterActive(callback) { if (document.prerendering) { document.addEventListener("prerenderingchange", callback, { once: true }); } else { callback(); } } // 延迟打点与动态加载 runAfterActive(() => { initViewTracking(); loadDynamicWidgets(); });
最终治理方案:对搜索引擎爬虫做精准熔断
复盘到最后,一个根本性的事实摆在眼前:
推测规则(Speculation Rules API)是 100% 服务于人类终端用户的感知加速技术,对于搜索引擎蜘蛛来说,它没有任何正向收益,反而是一枚随时引爆服务器算力与破坏缓存结构的定时炸弹。
蜘蛛不会像人类一样在页面上悬停、预读;蜘蛛需要的是稳定、完整、具备清晰状态码的单一事实来源。
与其在每一个业务组件里缝缝补补、谨小慎微地防范蜘蛛误触,最干净、最彻底的架构解法是在服务端把推测规则的下发对搜索引擎爬虫做彻底阻断。
我们在 Nginx 接入层配置了爬虫 UA 识别矩阵,并在 Node.js BFF / SSR 模板渲染入口做了一道环境熔断开关:
# Nginx 爬虫识别映射
map $http_user_agent $is_search_bot {
    default 0;
    ~*(Baiduspider|Googlebot|bingbot|Sogou|360Spider|Bytespider|YandexBot) 1;
}

# 将识别结果透传给后端 SSR 容器
proxy_set_header X-Is-Search-Bot $is_search_bot;
在后端页面模板输出逻辑中:
// 服务端 HTML 组装逻辑
function injectSpeculationRules(req) {
  // 如果请求来自搜索引擎爬虫,坚决不吐出推测规则标签
  const isBot = req.headers["x-is-search-bot"] === "1";
  if (isBot) {
    return "";
  }

  // 仅对人类访客下发经过严格审查的精简推测规则
  return `
    <script type="speculationrules">
    {
      "prefetch": [
        {
          "source": "list",
          "urls": ${JSON.stringify(getSafePrefetchLinks())},
          "eagerness": "moderate"
        }
      ]
    }
    </script>
  `;
}
改造上线后,整套技术生态终于重归秩序:
- 百度和谷歌的蜘蛛抓取日志恢复平稳,不再有由推测并发引发的 504 Gateway Timeout;
- 恶心的
/category/*畸形死链在监控里逐渐归零; - CDN 边缘节点对普通爬虫和访客分发全量页面快照,收录量与核心关键词排名在两周后全面回升;
- 而普通用户在桌面与移动端依然享有着由推测规则带来的极速翻页体验。
在新性能特性层出不穷的时代,追求极致速度固然没错,但永远不要忽视隐藏在浏览器底层与搜索引擎爬虫交互缝隙里的那些暗流。
文章标题:为了极致秒开给全站上了浏览器推测规则(Speculation Rules API)与链接预取(Prefetch),搜索收录与关键词排名却断崖式暴跌?排查预取并发打爆源站致蜘蛛频报 504、Vary: Sec-Purpose 缺失致 CDN 缓存残缺内容投毒快照、规则通配符被爬虫误抓炸出海量 404 与蜘蛛 UA 精准熔断我踩过的几个深坑
文章链接:https://www.llbbs.cn/jishujaocheng/292.html
本站文章均为原创,未经授权请勿用于任何商业用途
评论一下?