重构为前端孤岛架构后,搜索快照与核心词排名出现大面积残缺,问题源于`client:visible`懒水合被爬虫无视、`client:only`误用内链蒸发、JSON-LD滞后脱落和静态Chunk 404。爬虫渲染逻辑与真实浏览器差异导致问题,文章复盘排查过程及生产级防御方案。
上个月为了把站点从臃肿的传统 SSR 迁移出来,死磕 Lighthouse 100 分,我和团队花了两周时间把全站重构成了 Astro 的前端孤岛架构(Islands Architecture)。重构上线的那天,PageSpeed Insights 测速直接满分飘绿,LCP 压到了 0.8s,首屏没有一丝多余的 JavaScript,团队里大家都觉得这次架构演进选对了方向。
结果第三周看百度搜索资源平台和 Google Search Console,抓取和收录曲线直接走出了一个断崖式下跌。不仅原本排名前三的核心长尾词开始往下掉,用百度抓取诊断和 Googlebot URL 检查工具一跑,调出来的快照简直让人傻眼:文章上半部分正常,一过首屏,下半截的交互式代码演示、架构流程图、相关推荐全成了空荡荡的 <astro-island> 标签;更离谱的是,几百篇深度技术文章的富摘要在一夜之间全部脱落,后台还报了海量的静态 Chunk 404。
很多人以为用上静态孤岛架构天生对 SEO 友好,但实际把交互组件丢进生产环境,爬虫的渲染逻辑和真实浏览器完全是两码事。这里把这次排查出来的几个深坑和最终的生产级防御方案完整复盘一遍。
坑一:client:visible 懒水合遭遇爬虫无视口交互,快照下半截成了空壳占位符
重构初期,为了追求极速的首屏交互和最低的 Total Blocking Time (TBT),我们把页面上所有稍微重一点的交互组件都加上了 Astro 的 client:visible 指令。比如长文下半部分的交互式代码调试器、可折叠的架构流程图、多标签代码切换 Tab,以及底部的评论与推荐区。
client:visible 的底层逻辑很简单,它利用浏览器的 IntersectionObserver 监听组件容器。只有当用户滚动页面、目标 DOM 进入可视视口时,浏览器才会去异步加载对应的客户端 JavaScript chunk 并执行水合。在人类用户的 Chrome 浏览器里,这个过程如丝般顺滑。
但在搜索引擎爬虫的渲染沙箱里,这套机制彻底翻车了。
以百度蜘蛛(Baiduspider)和 Googlebot 的 Headless 渲染集群为例,它们的渲染引擎为了在海量抓取中压榨算力,有几个极其致命的行为特征:
- 默认视口固定:通常锁定在 1280x800 或移动端固定分辨率。
- 零合成滚动事件(No Synthetic Scroll):爬虫沙箱为了速度,渲染生命周期极短(通常在 3 到 5 秒),根本不会像人类那样模拟往下拉动滚动条。
- IntersectionObserver 触发缺失:在视口之外的 DOM 元素,由于没有滚动触发,永远处于不可见状态。
当时我们写的 Astro 页面大概长这样:
---
// ArticlePost.astro
import CodePlayground from '../components/CodePlayground.jsx';
import InteractiveDiagram from '../components/InteractiveDiagram.jsx';
import RelatedArticles from '../components/RelatedArticles.jsx';
---

<article class="prose">
  <h1>{title}</h1>
  <p>{introContent}</p>

  <!-- 位于首屏下方 1200px 处的重型交互组件 -->
  <CodePlayground client:visible code={sampleCode} />

  <!-- 架构流程图 -->
  <InteractiveDiagram client:visible data={diagramData} />

  <!-- 底部推荐文章 -->
  <RelatedArticles client:visible category={category} />
</article>
当组件使用了 client:visible,Astro 会在服务端输出一个带有内联 props 的 <astro-island> 自定义元素,内部在水合前通常只包含初始状态。如果你的 React 或 Vue 组件内部依赖客户端运行时来计算 DOM(例如组件内部通过 useEffect 或 useState 动态渲染高亮语法树、格式化参数),或者组件的静态兜底内容被客户端条件逻辑覆盖:
// CodePlayground.jsx (错误写法)
export default function CodePlayground({ code }) {
  const [isClient, setIsClient] = useState(false);

  useEffect(() => {
    setIsClient(true);
  }, []);

  if (!isClient) {
    return <div class="loading-placeholder">加载代码演练区...</div>;
  }

  return (
    <div class="code-editor">
      <pre><code>{code}</code></pre>
      <RunButton />
    </div>
  );
}在真实用户浏览器里,组件一旦滚入视口,马上水合完成并展示完整代码。但在爬虫眼皮底下,client:visible 永远没有触发水合,useEffect 根本没有执行机会。百度蜘蛛抓取后拍下的渲染快照里,正文关键的代码实现全变成了“加载代码演练区...”,核心技术关键词直接从快照里蒸发了。
防御改造:服务端静态脱水优先(SSR-First)与双轨指令
修复方案的核心原则是:孤岛组件在未激活水合前,服务端吐出的 HTML 必须是结构完整的脱水静态内容,绝不能返回空壳或 Loading。
我们重构了所有孤岛组件,彻底废弃了用 isClient 状态阻断首屏渲染的做法,改为服务端直出可读的静态 <pre><code>,客户端只负责挂载按钮等交互功能:
---
// ArticlePost.astro 改造后
import CodePlayground from '../components/CodePlayground.jsx';
---

<article class="prose">
  <!-- 对核心正文组件使用 client:idle,或者直接依靠静态 SSR 输出兜底内容 -->
  <CodePlayground client:idle code={sampleCode}>
    <!-- 通过 Astro Slot 传入服务端直出的静态内容,即使不水合也能被爬虫完整提取 -->
    <div class="fallback-code" slot="fallback">
      <pre><code>{sampleCode}</code></pre>
    </div>
  </CodePlayground>
</article>
如果内容确实属于核心长尾词的重要组成部分,不能冒任何未水合的风险,果断把 client:visible 换成 client:idle(页面主线程空闲时立即水合),或者直接拆解组件:把静态展示部分做成纯 Astro 组件(零 JS 输出),只把真正需要点击交互的细粒度小控件做成微型孤岛。
坑二:滥用 client:only 绕过 SSR 报错,核心内链在源码中彻底蒸发
这是我们在迁移过程中踩过的另一个大坑,罪魁祸首是团队成员为了偷懒省事。
在把旧版 React 组件搬进 Astro 时,某些第三方库(比如带有富文本编辑、Markdown 动态预览、或者依赖 window.localStorage 的组件)在 Node.js 服务端执行 astro build 打包时频频报错:ReferenceError: window is not defined。
有些同学嫌逐个用兼容逻辑包裹太麻烦,随手在组件上挂了 client:only="react"。Astro 文档里明确说明了 client:only 的作用:完全跳过服务端渲染,只在客户端由指定的框架进行挂载。
开发环境在浏览器里刷新一看,报错没了,组件渲染出来了,大家都以为万事大吉。
然而,我们看一眼 client:only 生成的真实静态 HTML 源码:
<!-- client:only 吐出来的 HTML 源码 -->
<astro-island
uid="Z1xYw2"
component-url="/_astro/RelatedLinks.1234.js"
component-export="default"
renderer-url="/_astro/client.5678.js"
props="{"tags":["Nginx","SEO"]}">
<!-- 此处空空如也,完全没有任何子节点 -->
</astro-island>挂了 client:only 的组件,在生成的 HTML 静态页面里就是一个空标签!服务端不会为其渲染任何一个字节的内部 DOM。
更命中的是,我们当时把底部的“相关技术专题内链(Related Links)”组件也挂了 client:only="react"。原本每篇文章底部都会包含 5 到 8 条指向本站深层技术文章的超链接 <a href="...">。随着重构上线,全站几百篇文章源码里的内链瞬间全部消失。
百度蜘蛛是出了名的“静态 HTML 优先”。对于没有建立高权重的深层页面,百度爬虫根本不会耗费昂贵的沙箱算力去给你跑 JavaScript 执行水合,它只解析原始的 HTML 源码提取超链接。源码里的内链一断,底层的几十篇长尾文章直接沦为了搜索引擎爬虫眼里的“孤岛页面(Orphan Pages)”,抓取频次断崖式下跌,新发文章连续两周一条都不收录。
防御改造:封禁业务级 client:only,内链必须原生 <a> 直出
我们在项目里定了一条硬性规范:任何承载正文文本、标题、超链接(尤其是内链导航)的组件,严禁使用 client:only。
对于那些必须依赖浏览器全局对象的组件,正确的做法是用纯 Astro 组件在服务端拼装静态链接,或者使用动态 import() 在客户端挂载增强层:
---
// RelatedLinks.astro (改用纯 Astro 静态模板)
const { currentCategory, tags } = Astro.props;
// 在构建期或服务端直接查出相关文章
const relatedPosts = await getRelatedArticles(currentCategory, tags);
---

<section class="related-links-box">
  <h3>相关技术排坑实录</h3>
  <ul>
    {relatedPosts.map(post => (
      <li>
        <!-- 核心内链必须是原生 HTML a 标签,保证爬虫在源码阶段直接提取 -->
        <a href={`/${post.slug}.html`} title={post.title}>
          {post.title}
        </a>
      </li>
    ))}
  </ul>
</section>
将这批组件彻底改回原生 Astro 静态输出后,重新构建并抓取验证:
curl -s -A "Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)" \
  https://www.llbbs.cn/nginx-tuning.html | grep -i "related-links-box"
终端里清晰地打印出带完整 href 的静态链接,深层页面的蜘蛛抓取量才在几天后逐渐拉回正常水位。
坑三:把 JSON-LD 结构化数据塞进客户端组件,富摘要一夜掉光
很多从传统 SPA 或 Next.js 转型过来的同学,习惯了组件级别的“自给自足”。在之前的代码里,每个业务组件自己负责管理自己的 Meta 和 Schema。比如文章详情组件内部,写着类似这样的代码:
// ArticleSchema.jsx (错误做法:在客户端组件里挂载结构化数据)
export default function ArticleSchema({ article }) {
  useEffect(() => {
    const script = document.createElement('script');
    script.type = 'application/ld+json';
    script.text = JSON.stringify({
      "@context": "https://schema.org",
      "@type": "TechArticle",
      "headline": article.title,
      "datePublished": article.publishDate,
      "author": { "@type": "Person", "name": article.author }
    });
    document.head.appendChild(script);
    return () => document.head.removeChild(script);
  }, [article]);

  return null;
}
在 Astro 页面里,如果这个组件被当作某个孤岛引入,或者被挂在带有延迟加载的指令下,灾难就发生了。
Google Search Console 突然发出大量告警:“结构化数据缺失”、“未检测到 TechArticle 架构标记”。原本在 Google 搜索结果中展示的精美面包屑路径、更新时间富摘要、作者标识全都在一周内彻底掉光,搜索结果变回了最普通的单调蓝链,点击率直接跌了接近 30%。
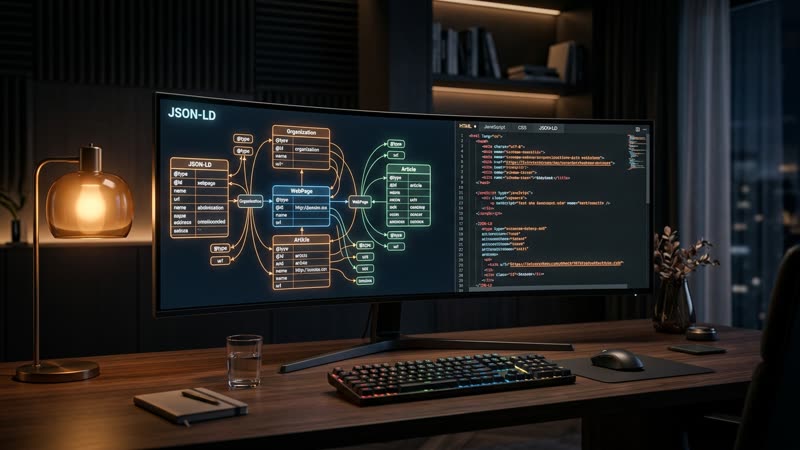
原因很简单:搜索引擎抓取器(Googlebot Structured Data Testing Tool、百度结构化数据解析器)在提取页面 Schema 时,首先且主要检查的是静态 HTML 的 <head> 区域。如果你的 JSON-LD 是由客户端 JavaScript 在 useEffect 挂载时动态往 DOM 里 append 的,在爬虫未执行 JS 或者沙箱超时未水合的情况下,这串数据在爬虫眼里根本不存在。
防御改造:结构化数据必须在 Astro Layout 的 <head> 静态固化
结构化数据是给搜索引擎看的,不是给浏览器用户交互用的,它根本不需要任何“水合”概念。
必须直接在 Astro 的顶级布局模板(BaseLayout.astro)的 <head> 标签内,通过纯 Astro 表达式在构建期将 JSON-LD 序列化输出:
---
// src/layouts/BaseLayout.astro
interface Props {
  title: string;
  description: string;
  articleMeta?: {
    headline: string;
    datePublished: string;
    dateModified: string;
    authorName: string;
    canonicalUrl: string;
  };
}

const { title, description, articleMeta } = Astro.props;

// 服务端构建期序列化 Schema
const schemaData = articleMeta ? {
  "@context": "https://schema.org",
  "@type": "TechArticle",
  "headline": articleMeta.headline,
  "description": description,
  "datePublished": articleMeta.datePublished,
  "dateModified": articleMeta.dateModified,
  "mainEntityOfPage": {
    "@type": "WebPage",
    "@id": articleMeta.canonicalUrl
  },
  "author": {
    "@type": "Person",
    "name": articleMeta.authorName
  }
} : null;
---

<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="utf-8" />
  <title>{title}</title>
  <meta name="description" content={description} />
  <link rel="canonical" href={articleMeta?.canonicalUrl} />

  <!-- 静态直出的 JSON-LD,零 JS 开销,爬虫抓取首包直接命中 -->
  {schemaData && (
    <script type="application/ld+json" set:html={JSON.stringify(schemaData)} />
  )}
</head>
<body>
  <slot />
</body>
</html>
使用 set:html={JSON.stringify(schemaData)},Astro 会在生成 HTML 文件的那一毫秒将合法的 JSON 字符串写入源码。不需要任何客户端运行时支持,任何爬虫只需发起一个最原始的 HTTP GET 请求,就能 100% 提取到合规的 Schema 标记。
坑四:SSG 静态打包发布导致 Nginx 缓存切片与旧 Chunk 404 吞噬抓取配额
Astro 在静态构建(SSG)时,所有的孤岛客户端代码都会被打包进 dist/_astro/ 目录下,文件名带有内容哈希(例如 hoisted.b9a1c2.js)。
上线初期,我们团队写了个自动发布脚本,每次触发 CI/CD 部署时,逻辑非常暴力:
# 危险的部署脚本!
astro build
rm -rf /var/www/myblog/*
cp -r dist/* /var/www/myblog/
这套暴力替换文件的做法,在配合 Nginx 或边缘 CDN 缓存时,引发了一场抓取灾难。
为了提高网站响应速度,我们在 Nginx 针对全站 HTML 开启了微缓存(fastcgi_cache 或 proxy_cache,有效时间配置为 10 分钟到 30 分钟)。当一次新版本发布发生时:
- 服务器上的旧静态 chunk 文件(如
hoisted.b9a1c2.js)被rm -rf瞬间删除了。 - Nginx 或 CDN 节点上仍然缓存着旧版本的 HTML 页面(缓存还有 15 分钟才过期)。
- 百度蜘蛛此时正好抓取了这个处于缓存期的 HTML 页面,解析 HTML 里的外链资源,顺藤摸瓜去请求
/_astro/hoisted.b9a1c2.js。 - Nginx 在磁盘上找不到该文件,直接返回了
404 Not Found!
几天之内,我们在百度搜索资源平台的“抓取异常”监控里看到了几千条 404 报错记录。百度蜘蛛在短时间内遇到大面积 404,判定站点可用性下降,开始强力压制抓取频次。本来每天有上万次的蜘蛛抓取配额,硬生生被压制到了几百次,新文章收录彻底停滞。
防御改造:静态资源版本累积保留与 Nginx 差异化缓存
解决这个问题的关键在两个地方:发布策略要做到“静态资源平滑滚动保留”,Nginx 缓存要做到“HTML 强校验,静态 chunk 长效强缓存”。
第一步,修改 CI/CD 部署逻辑,禁止清空 _astro/ 目录,只清理一个月前的旧资源,保留最近 5 次构建的所有 hash 文件:
# 优雅的平滑同步部署脚本
astro build

# 使用 rsync 增量同步,不加 --delete 参数,保留旧版本 chunk 文件
rsync -av --checksum dist/_astro/ /var/www/myblog/_astro/

# 同步 HTML 与根目录文件(允许更新和覆盖)
rsync -av --delete --exclude="_astro/" dist/ /var/www/myblog/
第二步,在 Nginx 中严格隔离 HTML 页面与静态资源的 Cache-Control 策略:
server {
    listen 443 ssl http2;
    server_name www.llbbs.cn;
    root /var/www/myblog;
    index index.html;

    # 1. HTML 页面:禁止浏览器与 CDN 强缓存,每次必须向源站协商验证
    location ~* \.html$ {
        add_header Cache-Control "public, max-age=0, must-revalidate";
        add_header X-Robots-Tag "all";
        try_files $uri $uri/ =404;
    }

    # 2. _astro 目录下的哈希静态文件:1年长效强缓存,不可变资源
    location ^~ /_astro/ {
        expires 1y;
        add_header Cache-Control "public, max-age=31536000, immutable";
        access_log off;
        try_files $uri =404;
    }

    # 3. 拦截异常的废弃 chunk 404,避免爬虫死咬不放
    location ~* \.js$ {
        try_files $uri =404;
        # 针对 js 文件的 404 快速断开,不记录严重错误日志
        open_file_cache_errors off;
    }
}
通过这套配置,HTML 页面永远能第一时间更新到最新版,而旧爬虫即便偶然拿着旧 HTML 过来抓取,磁盘上保留的旧 hash chunk 依然能够正常返回 200,抓取异常曲线在一周内降到了零。
坑五:Astro 默认样式聚合导致 HTML 首部体积膨胀,爬虫解析超时截断
在 Astro 的架构设计里,每个组件(不管是 .astro、.jsx 还是 .vue)自带的 <style> 标签默认属于 Scoped CSS(局部作用域样式)。
在进行生产环境打包时,Astro 为了减少额外的 HTTP 网络请求,默认开启了一项策略:把页面用到的所有组件样式聚合后,直接内联到生成的 HTML <head> 标签里的 <style> 中。
如果是一个单页只有几个段落的极简站点,这个默认行为非常棒,能省掉一个 CSS 握手请求。但我们的技术博客文章页面非常复杂:包含代码高亮主题(Prism/Shiki 生成的几百行 CSS 变量)、交互式流程图样式、侧边栏目录样式、评论框组件样式等。
构建完成后,我们用 curl 看了下一篇深度长文的原始 HTML:
curl -s -i https://www.llbbs.cn/tech-article.html | head -n 40整个 <head> 区域里塞了整整 180KB 的内联 CSS!真实的文章正文被挤压到了 HTML 的两万行之后。
这直接触碰到了搜索引擎爬虫的隐形抓取红线:
- 抓取体积与解析截断:很多国内搜索引擎蜘蛛(例如百度移动端抓取沙箱)对单页 HTML 源码的处理有体积限制,通常在 128KB 到 256KB 之间。如果头部内联样式过大,蜘蛛在读取完超大 CSS 块后,正文内容可能直接发生截断。
- 文本信噪比(Text-to-HTML Ratio)严重偏低:搜索引擎算法会评估页面的文本信噪比。正文只有 3000 字(约 6KB 文本),而页面充斥着 180KB 的样式代码,信噪比低于 5%,页面容易被反垃圾算法判定为模板膨胀页。
防御改造:关闭全局样式内联,强制分离外部样式表
要解决这个问题,需要在 astro.config.mjs 中对构建行为做显式约束:
// astro.config.mjs
import { defineConfig } from 'astro/config';
import react from '@astrojs/react';

export default defineConfig({
  integrations: [react()],
  build: {
    // 强制将样式表拆分为外部独立 css 文件,杜绝 HTML 头部体积暴增
    inlineStylesheets: 'never',
  },
  vite: {
    build: {
      cssCodeSplit: true,
    },
  },
});
将 inlineStylesheets 设置为 'never'(或者设置一个极小的阈值,比如只内联小于 4KB 的样式)。
重新构建之后,HTML 的 <head> 里只保留了一行干净的 <link rel="stylesheet" href="/_astro/style.hash.css">。单篇 HTML 文件的源码体积直接从 210KB 骤降到了 22KB,正文文字在第一屏网络包里就能被爬虫完整接收,文本信噪比瞬间提升到了 35% 以上。
做前端架构演进的时候,很多指标在开发环境里看起来都很美,但一旦涉及搜索引擎爬虫,任何客户端懒加载和局部水合的偷懒都会被放大成灾难。静态和交互之间从来不是非黑即白,把静态内容牢牢焊死在服务端 HTML 里,把交互孤岛严格限制在无 SEO 依赖的纯功能模块上,踩过这轮坑之后,整个架构的收录才算是真正稳住了。
文章标题:为了极致性能把全站重构为前端孤岛架构(Islands Architecture / Astro),搜索快照与核心词排名却大面积残缺?排查 client:visible 懒水合爬虫无视口交互致正文空白、client:only 误用内链蒸发、JSON-LD 结构化数据滞后脱落与静态 Chunk 404 我踩过的几个深坑
文章链接:https://www.llbbs.cn/jishujaocheng/298.html
本站文章均为原创,未经授权请勿用于任何商业用途
评论一下?