为防止恶意爬虫,站点接入Cloudflare Turnstile人机验证,但导致搜索收录与关键词排名大幅下滑。分析发现,爬虫沙箱环境下的Turnstile验证失败,且快照出现白屏,CDN缓存验证拦截页投毒快照。作者建议将安全验证改为SEO友好模式,兼顾安全与搜索引擎抓取。
上个月站点遭遇了一波持续多天的恶意爬虫扫荡,接口日志里每秒充斥着几十次自动化脚本的并发抓取,数据库 CPU 经常在半夜被拖到 90% 以上。为了彻底解决自动化脚本盗刷和垃圾注册问题,运维和安全团队一合计,决定在网关层接入 Cloudflare Turnstile,并在前端全站的公共布局(Layout)里统一挂上人机验证组件。
本地在 Chrome 里点开调试,效果确实立竿见影:无感人机验证几百毫秒内自动通过,脚本刷量瞬间被全部挡在门外,后台监控曲线一下子平稳下来。
然而好景不长,上线还不到十天,运营同学在群里发了紧急告警:Google Search Console 的有效网页收录量开始断崖式跳水,百度站长后台的索引量更是直接腰斩,几个原本排在搜索引擎首页的核心长尾词排名全面蒸发。
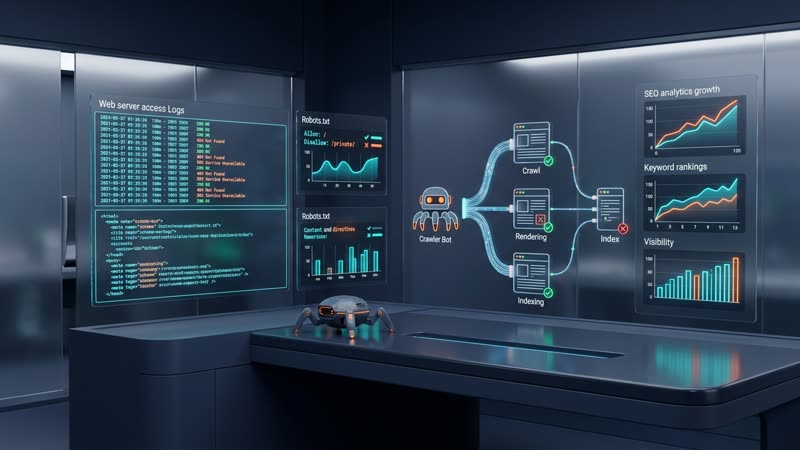
我打开百度站长后台的“抓取诊断”工具跑了一遍,抓取返回的状态码竟然是大面积的 403 Forbidden,抓取快照抓回来的全部是 Cloudflare 那个著名的“Just a moment... Please verify you are human”验证页面;而在 Google Search Console 的“实时测试”里,抓取到的 DOM 快照直接呈现为一片空白骨架屏,正文文字彻底蒸发。
在内容消费站点部署人机验证,如果直接照搬后台管理系统或金融表单的拦截思路,极易踩入搜索引擎抓取机制的盲区。把安全验证从“粗暴拦截”改造为“SEO 友好与安全兼顾”,背后涉及爬虫沙箱的渲染特性、边缘 CDN 的状态隔离以及合规蜘蛛的鉴权逻辑。我把排查过程中踩到的几个致命深坑与最终的生产级配置详细复盘在这里。
全局挂载验证门禁导致无状态爬虫沙箱直接停摆,快照正文大面积空白
最容易犯的第一个错误,是把人机验证组件当作类似全局导航栏一样的基础组件,直接套在前端的 Root Layout 根布局或者路由守卫(Router Guard)里。
很多前端团队的逻辑非常直观:页面首次加载时,先挂起所有数据请求,等 Turnstile 或极验组件的 SDK 加载完成并自动执行校验,拿到后端的验证 Token 后,再解开 Promise 去请求核心业务接口:
// 很多人下意识写出的前端验证拦截逻辑
export default function Layout({ children }) {
  const [verified, setVerified] = useState(false);

  useEffect(() => {
    // 等待人机验证 SDK 自动执行挑战
    window.turnstile?.render('#turnstile-container', {
      sitekey: 'YOUR_SITE_KEY',
      callback: (token) => {
        // 校验通过后才允许渲染正文或触发数据拉取
        setVerified(true);
      },
    });
  }, []);

  if (!verified) {
    return <div id="turnstile-container">安全环境检测中,请稍候...</div>;
  }

  return <main>{children}</main>;
}
在真实用户使用现代桌面或移动端浏览器访问时,Turnstile 会静默调用浏览器的硬件加速、WebGL 指纹、鼠标微小移动或 Canvas 环境特征,绝大多数情况下能在 500 毫秒内完成静默判定并触发回调。用户几乎感知不到阻碍。
但在搜索引擎爬虫的渲染环境里,这一套假设彻底崩塌。
不管是 Googlebot 的 Web 渲染服务(WRS),还是百度、必应的无头 Chromium 抓取集群,爬虫具备以下三个致命特征:
- 无状态与无交互沙箱:爬虫加载网页时,没有真实的物理鼠标,没有真实的屏幕滚动,甚至禁用了某些需要物理环境支持的 WebGL 或传感器 API。很多基于行为特征的人机验证在无头环境里判定为高危或无法判定,直接卡在等待用户手动点击交互的状态。
- 超时预算极其严苛:为了维持全球互联网每天数十亿网页的抓取吞吐,爬虫渲染沙箱对单个 URL 的 JS 执行与资源加载时间有硬性上限。通常在触发
DOMContentLoaded后,或者渲染定时器等待 2 到 3 秒后,沙箱就会强制对当前的 DOM 树执行序列化快照并提取文本。 - 不保留 Cookie 与 Storage 状态:绝大多数搜索引擎蜘蛛为了保证内容客观公正,抓取请求都是纯粹的无状态请求(Stateless Request),不持久化上一次访问的 Session、Cookie 或者 LocalStorage。每一次抓取都是全新的匿名请求。
在上面的代码逻辑下,爬虫进门后,Turnstile 根本无法在两秒内自动完成行为判定,setVerified(true) 永远不会被调用。爬虫抓取沙箱在超时那一刻截取的 HTML,就只有一行“安全环境检测中,请稍候...”。
搜索引擎的内容质量算法分析抓取到的快照,发现原本几千字的技术文章突然变成了不足 30 个字符的 Loading 占位符,直接把这个 URL 归类为“软 404(Soft 404)”或“低质薄内容”,历史权重与收录资格瞬间被剥夺。
CDN 边缘缓存未隔离校验状态,验证挑战页被公有缓存投毒
如果说前端全局门禁导致快照空白是逻辑层面的疏漏,那么 CDN 边缘缓存的配置失误就是直接摧毁全站收录的核弹。
为了在源站之前阻断大流量 CC 攻击,很多站点会在 CDN 边缘(例如 Cloudflare WAF 或者国内 CDN 的边缘规则)开启“托管挑战(Managed Challenge)”或基于 IP 的动态质询。
当边缘规则触发时,CDN 会向客户端返回一段包含验证挑战脚本的 HTML 页面(HTTP 状态码通常是 403 Forbidden,或者某些特定规则下的 200 OK)。
灾难往往发生在这个挑战响应的 HTTP 头上。如果源站或 CDN 的缓存规则配置不当,例如给页面配置了通配缓存规则:
# 危险的 CDN / 反代缓存配置
location ~* \.(html|htm)$ {
    proxy_cache my_cache;
    proxy_cache_valid 200 403 10m; # 很多人为了减轻源站压力,把 403 也顺手缓存了
    add_header X-Cache-Status $upstream_cache_status;
}
当某个没有携带有效通行凭证的爬虫或普通访客首先请求了这个页面,CDN 边缘节点拦截并生成了“验证您的浏览器”这一页 HTML。如果这个响应没有强制打上禁止缓存的响应头,CDN 会直接把这个挑战页缓存到边缘节点的内存和 SSD 上。
接下来的 10 分钟里,无论是合规的百度蜘蛛、谷歌蜘蛛,还是后面进来的成千上万个正常用户,只要命中同一个边缘节点,CDN 就会直接吐出之前缓存的 403 验证页面。
更隐蔽的一种情况是 HTTP 状态码为 200,但正文是验证码。在搜索引擎看来,这个 URL 返回了 200 OK,证明网页完全正常;接着提取网页标题和正文,标题变成了“请完成安全验证”,正文是验证码提示。几天之内,搜索引擎索引库里的几百个高质量文章快照,全部被这个验证页覆盖投毒。
要从源头上切断 CDN 投毒,必须在所有涉及人机验证的网关和边缘节点上,强制覆写响应头:
# 凡是触碰验证挑战的响应,强制打上强隔离防缓存头
location /api/verify/ {
    add_header Cache-Control "no-store, no-cache, must-revalidate, proxy-revalidate, max-age=0" always;
    add_header Pragma "no-cache" always;
    expires -1;
}只要响应内容包含人机验证表单或挑战状态,Cache-Control 必须是 no-store,绝不能给任何中间代理或 CDN 节点哪怕一秒钟的缓存机会。
粗暴依赖 User-Agent 放行爬虫,引来黑产伪造与搜索引擎作弊降权
排查出爬虫被验证码挡在门外后,很多团队最先想到的“快速止血”方案是在网关写一条基于 User-Agent 的白名单放行规则:
# 极度危险的简陋放行做法
set $is_spider 0;
if ($http_user_agent ~* (Baiduspider|Googlebot|bingbot)) {
    set $is_spider 1;
}

if ($is_spider = 1) {
    # 遇到蜘蛛直接跳过 Turnstile 验证
    proxy_pass http://backend_cluster;
}
这种直接放行的写法看似立竿见影,实则同时引爆了两个方向的重大风险:
第一个风险是防爬机制形同虚设。任何黑产团伙和自动化脚本采集软件,只需要在 Python 的 curl、requests 或抓取工具头部加上一行:
curl -H "User-Agent: Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)" https://example.com/article/123你费尽心思配置的 Cloudflare Turnstile、极验或滑块验证码,瞬间被绕得一干二净。服务器的数据库和 CPU 会再次被伪装成百度蜘蛛的黑产脚本打到瘫痪。
第二个风险更为致命:触犯搜索引擎的 Cloaking(障眼法/隐形作弊)红线。
搜索引擎严厉打击任何“给蜘蛛看一套内容,给普通用户看另一套完全不同内容”的行为。如果普通用户未开启 JS 或网络受阻时,访问文章直接被强行拦截在验证码页面无法阅读,而搜索引擎看到的却是完整的长篇大论,当搜索引擎通过隐蔽的巡检 IP、移动端双重模拟或者算法比对检测出内容巨大差异时,整个域名会直接被判定为恶意 Cloaking 作弊,面临搜索结果全部拔毛的人工处置(Manual Action)。
放行搜索引擎必须建立在合规的架构设计之上,绝不能用一条简单的 UA 正则草率应付。
Nginx 逐次同步反查 rDNS 拖爆 Worker,爬虫抓取大面积报 504
既然 UA 容易被伪造,正规的爬虫验证方案是什么?
主流搜索引擎官方给出的方案都是双向 DNS 反查(Reverse DNS Lookup,即 rDNS):
- 拿到来访客户端的 IP 地址,通过系统的 DNS PTR 记录反查其域名(例如反查出
crawl-66-249-66-1.googlebot.com或baiduspider-220-181-108-77.crawl.baidu.com)。 - 校验域名后缀是否合法属于
.googlebot.com、.google.com或.baidu.com。 - 再拿这个反查出来的域名做一次正向 A 记录解析,看解析出来的 IP 是否与当前客户端的真实 IP 完全一致。
只有双向匹配成功,才能确认为真正的官方蜘蛛。
原理非常严密,但如果直接把这套双向解析逻辑硬编码在 Nginx 的请求链路上(例如在每个请求到来时调用 Lua 或外部脚本执行同步 DNS 解析):
-- 致命的同步阻塞反查逻辑(反面教材)
local resolver = require("resty.dns.resolver")
-- 每一个外部请求都现场发起两次同步公网 DNS 请求
local ptr_name = do_reverse_lookup(client_ip)
local forward_ip = do_forward_lookup(ptr_name)
在公网环境里,DNS 查询的耗时是不稳定的。正常的 DNS 查询通常在 10 到 50 毫秒,但在高并发抓取期、或者上游公共 DNS 服务器偶发抖动时,单次查询可能耗时 1 到 3 秒。
搜索引擎抓取往往是高并发的,一个抓取任务可能每秒同时派出 30 到 50 个并发线程。当几十个请求在毫秒级内涌入,Nginx 的 Worker 进程会迅速被阻塞在等待 DNS 响应的系统调用上。
连接池瞬间被耗尽,后续进入的请求开始超时排队。此时不仅爬虫抓取频报 504 Gateway Timeout,连带正常用户的访问也彻底卡死。搜索引擎一旦检测到大面积 504 超时,会立刻自动压低抓取频次(Crawl Budget),新文章往往数周得不到抓取。
解决这个瓶颈的关键,是采用静态 IP 网段白名单结合本地带 TTL 缓存的验证机制。
各大搜索引擎实际上都会公布其官方爬虫的固定 IP 段(例如 Googlebot 的官方 IP 列表每天以 JSON 格式公开发布,Cloudflare 等服务商也会直接提供经过认证的 cf-bot-management 标记)。
对于纯自建的 Nginx 架构,可以通过 Nginx 的 geo 模块预载官方爬虫的常用网段,并在网关层利用共享内存(lua_shared_dict)给已验证的蜘蛛 IP 建立 24 小时的本地缓存,彻底避免实时同步解析拖垮网络连接。
生产级隔离架构:动静分离与合规爬虫优雅降级方案
彻底兼顾 SEO 友好性与人机防刷的核心设计思想其实非常朴素:
绝不把人机验证放在内容阅读的“只读路径(Read Path)”上,而是将防护重心收缩到高危的“写入与突发路径(Write / Mutation Path)”。
技术文章、博客列表、产品详情这些公开的只读页面,天生就是需要被全世界(包括搜索引擎、社交媒体分享爬虫、RSS 抓取器)公开读取的。对这部分页面做强人机验证,本质上是在用安全的名义自断流量手脚。
真正应该严防死守的,是评论提交、点赞打赏、注册登录、站内高消耗搜索以及大量导出等接口。
在实际生产部署中,我们落地了以下三套组合策略:
1. 架构动静分离:公开页面只读免验,敏感操作延迟弹框验证
公开文章页面在服务端渲染(SSR)或静态生成(SSG)时,向所有访客(无论是爬虫还是用户)直接吐出完整的语义化 HTML。
当真实用户在页面上点击“提交评论”或“点赞”等需要防刷的交互时,前端组件才动态调用 Turnstile 的显式渲染方法,弹起无感验证或完成 token 签名,随同 POST 请求发送给后端接口:
// 优雅的做法:只在交互触发时按需验证,不阻塞页面首屏正文
async function handleCommentSubmit(commentData) {
  // 1. 调用已就绪的 Turnstile 获取本次操作的一次性 Token
  const token = await new Promise((resolve) => {
    window.turnstile.render('#action-verifier', {
      sitekey: 'YOUR_SITE_KEY',
      size: 'invisible', // 隐式无感验证
      callback: (t) => resolve(t),
    });
  });

  // 2. 将 token 携带在写操作请求体中
  await fetch('/api/comments/create', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({ ...commentData, turnstile_token: token }),
  });
}
这样处理后,搜索引擎爬虫抓取任何文章页面,读取到的都是原汁原味的完整文章正文、标题与结构化数据;而黑产脚本试图批量刷垃圾外链、批量发垃圾评论时,依然必须通过后端的严格人机验证。
2. Nginx 网关层基于官方 CIDR 与受信任标头的精细化路由
如果某些特殊页面(例如必须防全量搬运的高价值目录页)确实需要做整站防刷,可以利用 Nginx 的 geo 模块加载官方搜索引擎的已知网段,并配合安全隔离响应头:
# 在 http 块中定义受信任的搜索引擎爬虫网段(示例收录部分常用段)
geo $trusted_spider {
    default 0;
    # Googlebot 官方活跃网段
    66.249.64.0/19   1;
    66.249.80.0/20   1;
    66.249.90.0/24   1;
    # 百度爬虫官方常用网段
    116.179.32.0/20  1;
    220.181.108.0/24 1;
    123.125.71.0/24  1;
    # 本地局域网回环
    127.0.0.1        1;
}

server {
    listen 443 ssl;
    server_name example.com;

    location / {
        # 针对受信任的搜索引擎网段,直接放行,不附加验证门禁
        if ($trusted_spider = 1) {
            proxy_pass http://backend_ssr;
            break;
        }

        # 普通流量走标准保护链路
        proxy_pass http://backend_ssr;
    }

    # 凡是触碰验证码或鉴权挑战的接口,彻底封死 CDN 缓存
    location /challenge/ {
        add_header Cache-Control "no-store, no-cache, must-revalidate, max-age=0" always;
        add_header X-Robots-Tag "noindex, nofollow" always;
        proxy_pass http://auth_service;
    }
}
注意上面的 X-Robots-Tag: noindex, nofollow 响应头:凡是验证码落地页、挑战中转页,必须显式通知任何漏网爬虫禁止索引该页面,彻底避免验证码文字被收录进快照。
3. 本地验证排查指南:模拟真实爬虫验证快照
在整改完成后,不要干等一周看站长平台的数据变化。通过命令行直接模拟无状态爬虫发起探测,能第一时间检验响应是否合规:
# 模拟 Googlebot 抓取文章页面,验证是否直接返回完整 HTML 正文而非挑战脚本
curl -s -L -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" \
  -H "Accept: text/html,application/xhtml+xml" \
  https://example.com/article/123 | grep -i "turnstile"

# 检查返回的响应头是否误带了公有缓存指令
curl -I -s -A "Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)" \
  https://example.com/article/123 | grep -E -i "cache-control|x-cache|set-cookie"
如果在输出中不再看到任何强制加载人机验证 SDK 的阻塞代码,且正文能完整提取,说明爬虫通道已经恢复正常。
把防护重心从无差别的全站内容拦截,调整为针对高危写操作与异常流量的精细化鉴权,既能挡住自动化脚本,也不会把辛苦积累的搜索引擎收录和权重断送在安全验证页面里。
文章标题:为了防刷与人机验证给全站接入了 Cloudflare Turnstile 与行为验证码,搜索收录与关键词排名却断崖式暴跌?排查蜘蛛抓取遭遇 JS 挑战致快照白屏、CDN 缓存验证拦截页投毒快照、无 Cookie 爬虫触发 403 阻断与合规蜘蛛双向 rDNS 放行我踩过的几个深坑
文章链接:https://www.llbbs.cn/jishujaocheng/297.html
本站文章均为原创,未经授权请勿用于任何商业用途
评论一下?